Исследователь из института Макса Планка и ETH Цюриха предложили крайне элегантный способ генерации правдоподобных людей на заданных 3D сценах. Давайте обсудим почему это интересно и углубимся в детали этой работы.
Текущая конъюнктура
Индустрия и научные институты всё больше занимаются диджитализацией окружающего нас мира. В то время как Apple (и другие производители смартфонов и планшетов) добавляют в новые девайсы датчикии глубины и LiDAR (пример работы можно увидетьв этом видео), исследователи со всего мира неустанно ищут новые способы использования новых данных. Эти данные в большинстве своём состоят из 3D сканов общедоступных помещений, таких как квартиры, офисы, аудитории и столовые, с высокой степенью детализации. Уже существует множество треков задач, которые работают с такими данными: семантическая и инстанс сегментация предметов интерьера в работе OccuSeg или восстановление утраченных деталей в ходе сканирования в статье моей научной группы Part-Based Understanding of RGB-D Scans. Эти задачи (и обилие других задач) основопологающие для создания интеллектуальных помощников, которые могут облегчить жизнь в их собственном доме для людей с деменцией, или пожилых, или людей с инвалидностью. Ни для кого не секрет, что 3D среды, такие как помещения, могут содрежать в себе людей, как объекты, но на сегодня большинство из имеющихся датасетов не располагают такой информацией. Авторы статьи PLACE (PLACE: Proximity Learning of Articulation and Contact in 3D) своей работой устраняют это значимое ограничение существующих 3D виртуальных реальностей, таких как Habitat. Они предлагают метод, который генерирует меши людей внутри 3D сред.
 Рендеры из статьи (источник)
Архитектура
Давайте подробнее рассмотрим компоненты метода.
Basis Points Set
PLACE опирается на идею базисных точек, предложенную в работе с ICCV 2019.
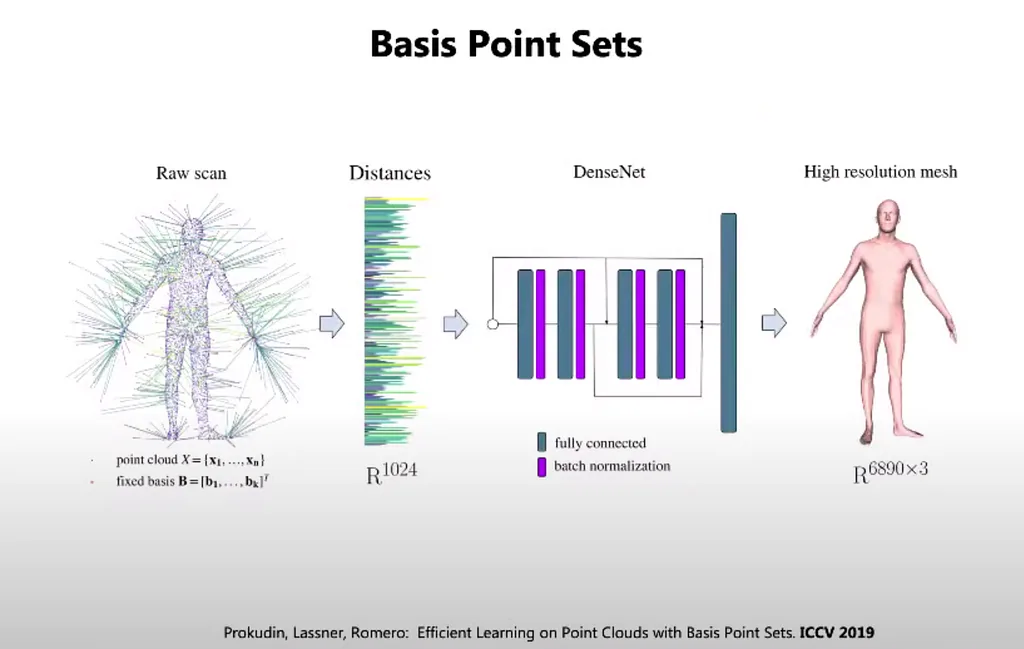
Они кодируют сырые облака точек тел с помощью расстояний до фиксированного набора базисных точек в пространстве, затем используют это кодирование для того, чтобы вывести полный меш тела человека в высоком разрешении из SMPL-X с помощью незамысловатого MLP. То, что базисные точки фиксированы, означает, что различным облакам точек тел, мы будем ставить в соответствие расстояния до одних и тех же точек в пространстве. В оригинальное статье число используется 1024 точки для кодирования, в PLACE это число увеличено до 10k. Как вы можете видеть на слайде выше, кодировать человека в пространстве таким методом можно без знаний о среде, которая его окружает.
Но авторы пошли дальше и предлагают нам способ создания представления взаимодействия человека и сцены (human-scene interaction representation).
 BPS сцены и BPS признаки
Если даны меш сцены (3D среда) и меш тела человека, становится возможным создать базисные точки на вершинах сцены. Отсюда вытекают два определения BPS сцены — набор фиксированных базисных точек на сцене и BPS признаки — расстояния от базисных точек до меша человека. В этом видео вы можете увидеть, как различным телам в среде с фиксированным BPS соответствуют различные наборы расстояний, по этой причине каждая поза кодируется своими BPS признаками.
Distance-based human mesh generator
 Архитектура генератора меша человека
Чтобы создать генератор, который будет производить реалистичные тела, авторы предлагают использовать следующий пайплайн обучения. По данным сценам и мешам людей на них они вычисляют BPS признаки (расстояния) и учат вариационный автоэнкодер (VAE) восстанавливать эти расстояния. Затем эти восстановленные признаки тел подаются MLP, чтобы регрессировать их в целые тела. Т.е. по ограниченному набору расстояний восстановить полные облака точек тел людей. На выходе MLP две вещи: глобальный перевод в пространстве (global 3D translation) для всех вершин тела и промежуточная реконструкция непосредственно вершин тела, их сумма даёт искомую реконструкцию. В качестве исходных данных для обучения моделей в этой статье используется датасет PROX.
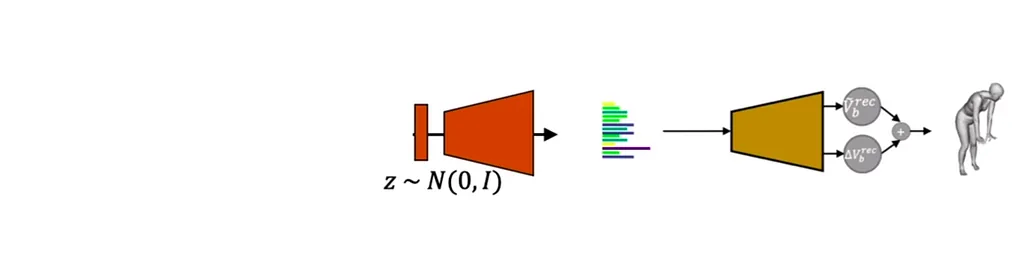
Во время использованния обученной модели, мы можем семплировать векторы из нормального распределения и подавать их на вход декодера нашего VAE. Это будет являться пайплайном генерации.
Вы могли заметить, что обученная таким образом модель может работаь лишь с одной сценой и одним набором базисных точек на меше сцены. Мы обсудим, как авторы предлагают преодолеть эту проблему после небольшого экскурса в вариационные автоэнкодеры, упомянутые выше.
Короткое введение в Вариационные Автоэнкодеры
В обозреваемой работе VAE используются для реконструкции мешей человека и, как мы увидим далее, для получения представления окружающей человека среды. Чтобы быть на одной волне, давайте немного обсудим принцип работы VAE (вариационного автоэнкодера).
 Пример работы автоэнкодера на одной из картнок MNIST
Стандартный автоэнкодер состоит из двух частей: энкодера и декодера. Энкодер сжимает многомерные данные, такие как 3D меш, в представление гораздо меньшей размерности, обычно в некоторой вектор размерности N. Декодер, наоборот, разжимает такой вектор в исходный формат. Две эти части являются нейронными сетями, которые учатся совместно, используя reconstruction loss. Такой лосс улучшает сопособность энкодера отсеивать лишнюю информацию и способность декодера производить результаты близкие к тому, что поступает на вход энкодера.
Автоэнкодеры можно использовать как генераторы данных, похожих на представителей исходной обучающей выборки. Но декодеры классических автоэнкодеров зачастую производят валидные данные (например картинки) только из векторов (latent vectors), которые декодер видел на обучении. Чтобы преодолеть это ограничение мы можем использовать вариационные автоэнкодеры или VAE.
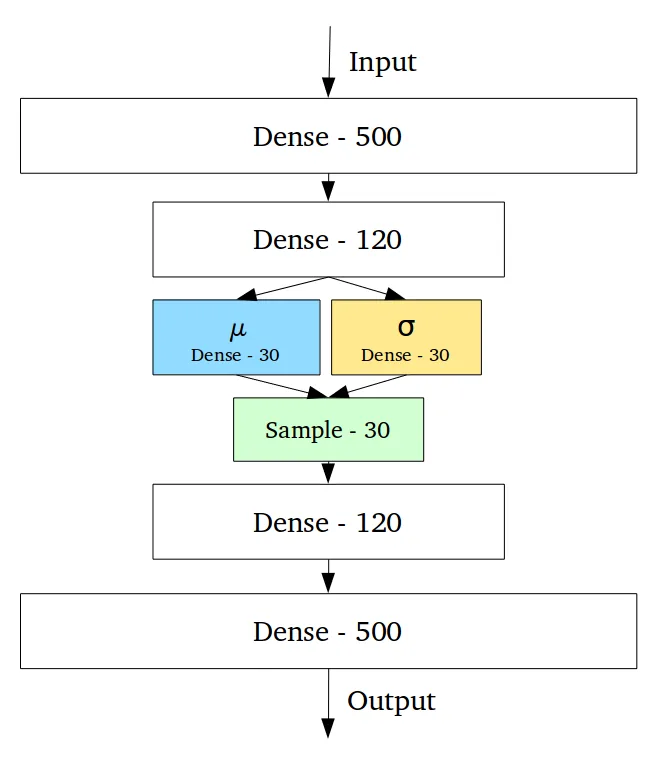
Взгялнем на картинку из этого поста. В середине сети мы видим μ, σ и Sample слои. Основное отличие двух моделей заключается в том, что классический AE для каждого входа производит одно внутреннее представление, например длины 30, а VAE, в свою очередь, создаёт два вектора параметров нормального распределения (мю и сигмы). В этом случае, внутренним представлением для конкретного входа будет реализация случайного вектора с этими параметрами, т.е. не фиксированное значение.
Такой подход делает наше кодирование устойчивым к флуктуациям вектора представления, поскольку в этом случае декодировщик учится предсказывать один выход не для одного вектора, а для множества близких, распределенных с одним набором параметров (μ и σ), векторов в пространстве. Такой автоэнкодер обучается с помощью двух лоссов: reconstruction и KL дивергенции. Второй, в этом конкретном случае, используется для того, чтобы парметры μ, σ при обучении, приближались к параметрам стандартного нормального распределения (т.е. к 0, I). Вы можете узнать больше с какими весами как эти лоссы учитываются вместе из этого вопроса.
Two-stage distance-based human-scene encoding
Возвращаясь к задаче генерации людей, нельзя отрицать, что очень важно уметь генерировать людей не только на одной заданной сцене, но и на любой данной. Чтобы преодолеть эту проблему авторы предлагают кодировать сразу и людей, и саму сцену, использую технику базисных точек и VAE.
 Кодирование расстояниями сцены (синим цветом, верхняя подмодель) и кодирование тела (оранжевым цветом, нижняя подмодель)
Базисные точки фиксируются на стенах и потолке кубической виртуальной клетки в 3D пространстве. Один и тот же набор базисных точек используется для любого кропа входных сцен из обучающего датасета PROX. Этот подход помогает выучить и контекст вокруг человека, и сами признаки меша тела человека. Автоэнкодер человека становится обусловленным VAE (conditional VAE), поскольку теперь он обусловлен внутренним представленнием сцены. На практике этот conditioning может быть достигнут с помощью склеиваиния латентных векторов из двух энкодеров (VAE сцены и VAE человека), при подаче на вход декодеру генератора человека (см. картинку выше)
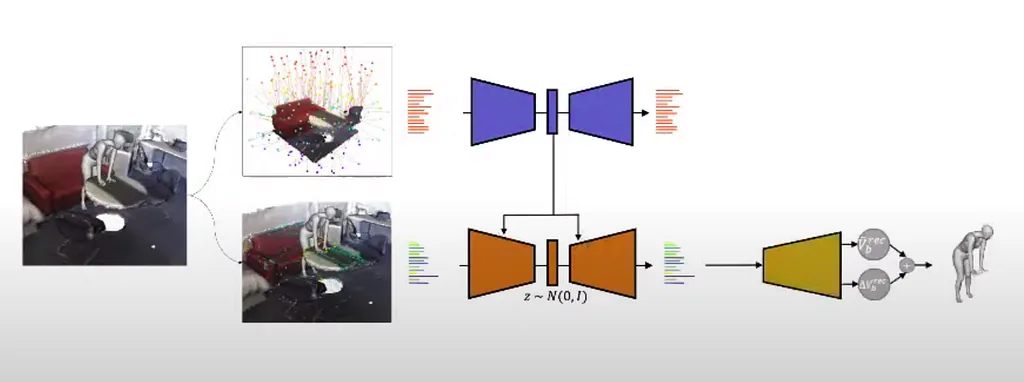
Поверх предложенных двух VAE применяется MLP, который получает меш человека высокого разрешения. Согласно авторам этот подход показывает неплохие результаты, но они становятся еще лучше, если к архитектуре добавляется еще один автоэнкодер.
 VAE для абсолютных (x,y,z) позиций сцены (зеленым цветом, самый верхний автоэнкодер)
Исследователи предлагают кодировать сцену не только расстояниями, но и абсолютными положениями (x,y,z) поверхности меша. За такое кодирование ответственнен дополнительны VAE, его внутренние представления подаются в MLP в конце модели для обуславливания.
Interaction-based optimization
Последним шагом всего метода PLACE является оптиимизация на базе взаимодейтсвий.
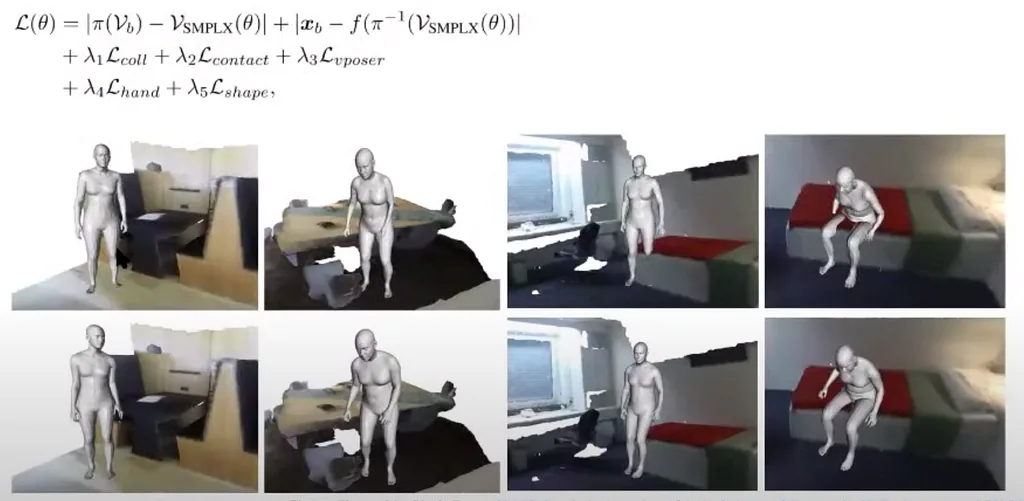
В статье представлен комплексный лосс, налагаемы на параметры модели тела theta. Такой лосс призван преодолеть с одной стороны пересецение мешей человека со сценой (как в третьем столбце справа), так и с другой стороны, заставить нейронную сеть выдавать более реалистичные позы человека (как в первом столбце).
Оценка результатов
Чтобы оценить качество результатов, авторы прибегают к помощи ассессоров. Они написали инструмент, в котором пользователь может сравнить два различных меша человека в сцене и решить, какая из моделей генерирует “лучший” вариант.
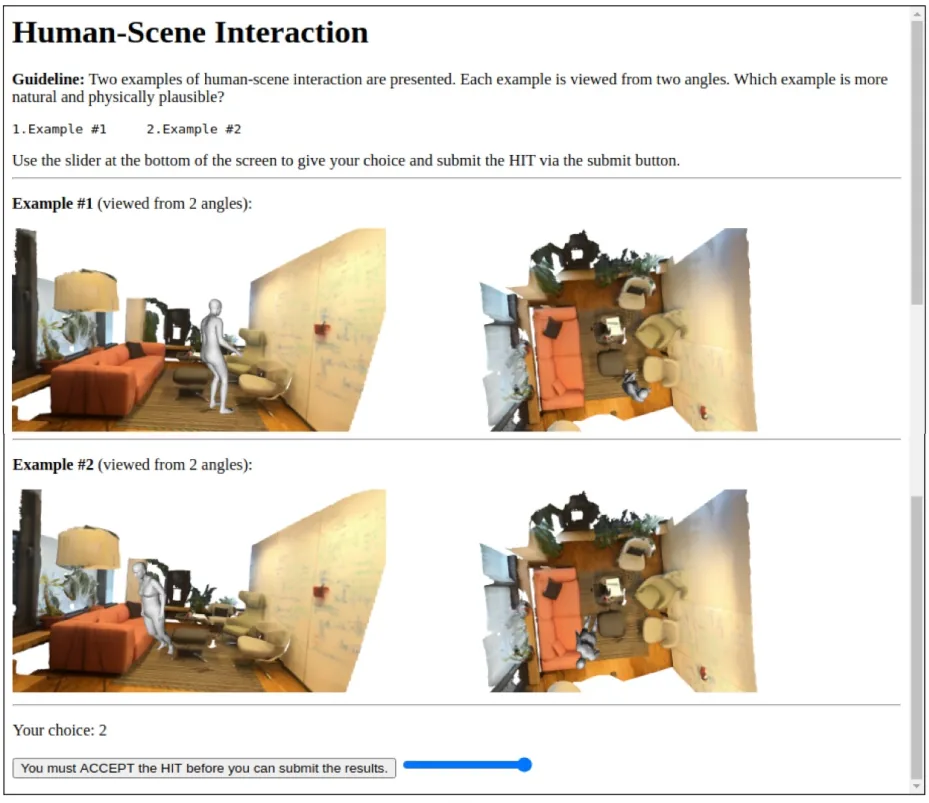
Это приводит к следующим результатам.
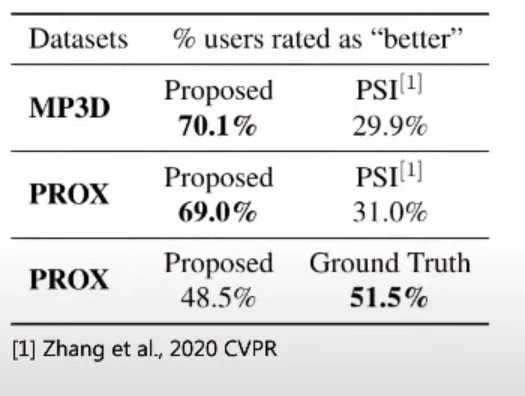
Во время оценки, приблизительно 70% пользователей считают предложенную модель лучше чем модель PSI (модель от тех же авторов, представленная ранее) на двух датасетах. И очень воодушевляет, что 48.5% пользователей посчитало, что результат работы модели PLACE работает лучше непосредственно ground truth из датасета PROX. Но здесь нужно принять во внимания, что модель была обучена на этом датасете, чисел на датасете MP3D не представлено.
Show me the code!
В заключение хочу сказать, что это статья показывает нам великолепные результаты в сфере генерации людей в 3D. Такие результаты могут ыть полезны исследователям и разработчикам, которые работают с оцифрованными помещениями, возможно, в ближайшем будущем мы увидим как схожие подходы используются в виртуальных помощниках или компьютерных играх, кто знает. Одно известно наверняка, вы можете воспроизвести резульататы этой статьи уже сегодня, поскольку авторы предоставили кодовую базу их экспериментов, и она доступна на github.
Впервые опубликовано на Medium.